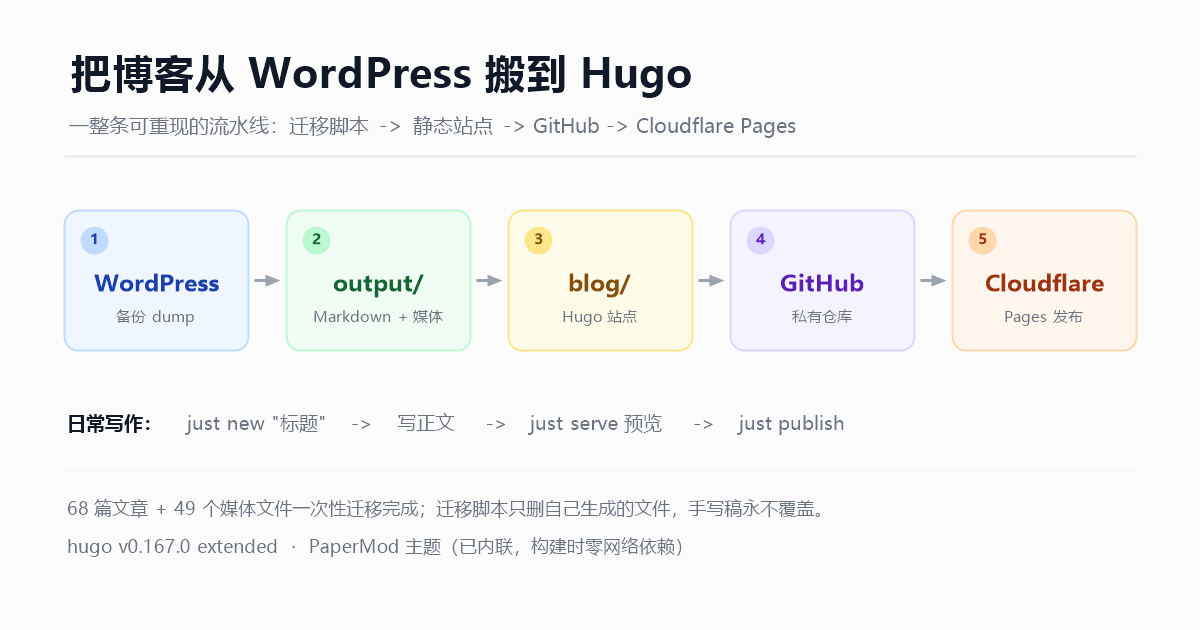
这个博客原来跑在 WordPress 上。前几天我把它整个搬到了 Hugo,静态托管在 Cloudflare Pages 上,顺手把「写文章」这件事也重新做了一遍。这篇算是迁移完成后的第一篇,把整条流水线 从头到尾记一遍:数据怎么搬、Hugo 怎么构建、文章怎么写、发布怎么做,以及中间踩过的坑。

为什么要搬
不是为了追新,是几个很具体的成本问题:
- WordPress 要一整套 PHP + MySQL 才能发几十篇文章,备份、升级、插件都得操心;
- 文章在数据库里,想用
grep找一句话都做不到; - 静态站可以把每一篇文章、每一张图都放进 Git,改了什么一目了然,回滚就是
git revert。
真正的难点不是 Hugo——Hugo 半天就能学会。难点是把旧数据从 WordPress 里挖出来: 一份 mysqldump、一个 uploads 压缩包,还有一堆埋在 PHP 序列化字段里的配置。
迁移思路:把"读不出来"变成"可 grep"
我写了一个叫 wp2md 的小工具,核心思路是分三层拆开,每层只干一件事:
| 层 | 输入 | 输出 | 干什么 |
|---|---|---|---|
| 数据 | mysqldump | SQLite | 解析 dump,还原成能查询的表 |
| 内容 | SQLite | output/*.md | HTML → Markdown,保留 front matter |
| 站点 | output/ | blog/ | 生成 Hugo 的 content/ 与 static/media/ |
拆开的好处是每层都能单独重跑、单独校验。图片路径对不上时,我只需要重跑媒体那一步, 不用把整条迁移链从头再走一遍。
另外两个刻意的决定:
- 只依赖 Python 标准库。
pyproject.toml里dependencies = []。移植这种一次性的 数据清洗脚本,最怕的就是半年后想改一处,环境却装不回来了。标准库版本放三年也能跑。 - Hugo 二进制随项目走。
tools/hugo/hugo.exe(v0.167.0 extended)直接提交进仓库, 构建时零网络依赖。
最后的结果:68 篇已发布文章 + 2 篇私密草稿、4 条说说、49 个媒体文件(5.8 MiB),
一次迁移完成。旧文章原来的固定链接 /archives/<id> 也全部换成了新的可读地址。
Hugo 是怎么构建的
Hugo 的心智模型很简单:content/ 是输入,public/ 是输出,中间的一切都是配置。
blog/
├── hugo.yaml          站点配置(baseURL、permalinks、菜单、主题参数)
├── content/           文章和页面(Markdown + front matter)
├── static/            原样拷贝进 public/ 的文件(我的图片都在 static/media/年/月/)
├── themes/PaperMod/   主题(内联成普通文件,不是 git submodule)
├── layouts/           覆盖主题的模板
└── public/            构建产物,已在 .gitignore 里
几条配置值得说明:
permalinks.posts = "/archives/:slug/"——文章的网址完全由 front matter 里的slug决定。所以slug是个要慎重的字段,改了它等于换网址。markup.goldmark.renderer.unsafe = true——旧文章里混着<br>、<u>、<sup>这类原生 HTML,不开这个开关它们会被转义成字面文本。outputs.home加了JSON——给 PaperMod 的客户端搜索提供索引,纯静态站也能全文搜索。- 主题内联而不是 submodule ——私有仓库 + 构建机的组合下,submodule 容易拉不下来, 内联之后构建机完全不需要访问 GitHub。
还覆盖了 4 个模板文件,原因都写在那几个文件的注释里,简单说两类:一是 PaperMod 还在用
Hugo 0.158 已经改名的 API(.Language.LanguageCode → .Language.Locale),二是把
> [!WARNING] 这种 GitHub 风格的提示块渲染成真正的样式化提示块,而不是字面显示
[!WARNING]。所以 Hugo 版本不能低于 0.158。
踩过的坑
迁移的代码本身没出什么大问题,正式的坑全在发布环节。
坑一:把"构建输出目录"填进了"根目录"。 Cloudflare 的「根目录(Root directory)」指的是仓库里的构建工作目录,不是产物目录, 而且它在 clone 完成后立刻检查,不存在就直接失败:
Cloning repository...
Failed: root directory not found
真正的原因更绕:我当时是在 Workers 的流程里建应用,那个表单里有「构建命令 / 部署命令 /
构建令牌」,没有「构建输出目录」这一栏。于是我顺手把 public 填进了名字最像的「根目录」,
还带了前导斜杠。正确的是在 Pages 里建:它有「构建输出目录」,根目录留空。
坑二:域名差一个字母。
baseURL 写的是 www.kutake.com,而我的域名是 www.kutake.top。现象极其迷惑——
首页能正常打开,点任何一篇文章都跳到另一个域名上去。因为 baseURL 会被写死进所有
绝对链接:文章地址、封面图、sitemap、RSS、og:image 全是它。
注意
部署前一定确认
hugo.yaml里的baseURL和正式域名逐字一致(含协议和结尾斜杠)。 这个错误不会让构建失败,只会让所有链接悄悄指向别处。
文章怎么写
这部分我最想重做。原来在 WordPress 后台点来点去,现在:
just new "文章标题"                                  # 新建,默认草稿
just new "文章标题" --tags 生活,摄影 --categories 随笔
just new "文章标题" --cover /media/2026/10/cover.jpg
just new "文章标题" --publish                        # 直接发布
它会生成 content/posts/YYYY-MM-DD-<slug>.md 并填好 front matter。字段的形状定义在
blog/archetypes/posts.md 里,所以想加字段只改那一个文件——命令行工具和 Hugo 原生的
hugo new content 用的是同一份骨架。当前一篇新文章的 front matter 长这样:
---
title: "文章标题"
date: 2026-10-14T04:21:21+08:00
draft: false
slug: "wordpress-to-hugo"      # 决定网址
author: "kutake"
categories: ["折腾"]
tags: ["Hugo", "Cloudflare"]
cover:
  image: "/media/2026/10/cover.png"
  alt: "文章标题"
  caption: ""
---
两个约定:
- 图片统一放
blog/static/media/YYYY/MM/,引用时写站内绝对路径/media/YYYY/MM/xxx.png。 和迁移过来的 49 张旧图保持同一套规则,不用记两套。 - 草稿不会上线。
draft: true的文章在本地预览里能看到,但不会进正式构建;写完把draft改成false,或者建的时候就加--publish。
编辑器方面,仓库里放了一份 VS Code 片段(post / fm / cover / alert / more / img,
敲前缀按 Tab 展开),用 Obsidian 的话把 content/posts/ 当 vault 打开也行——粘图片最顺手。
怎么发布
发布就是一次 git push:
写文章  →  git push  →  Cloudflare Pages 构建  →  自动上线
                        (hugo --gc --minify)
Cloudflare Pages 那边的配置是固定的四项:
| 项目 | 值 |
|---|---|
| Framework preset | Hugo |
| Build command | hugo --gc --minify |
| Build output directory | public |
环境变量 HUGO_VERSION | 0.167.0 |
根目录留空(仓库根就是 Hugo 站点根)。HUGO_VERSION 必须设,否则 Cloudflare 可能用
一个低于 0.158 的 Hugo 版本,构建直接报错。
本地想先看一眼:
just serve     # http://localhost:1313,含草稿,保存即刷新
just build     # 构建到 blog/public/
just verify    # 校验产物:媒体链接、编码、时区、提示块
just verify 是我特意加的——迁移最怕的是"看起来能打开,其实一半图片是断的"。
它现在会检查 61 个点,包括 101 处 /media/ 引用是否都命中真实文件。
一个细节:重新生成不会删掉你的稿子
因为 blog/content/ 里的 68 篇老文章是脚本生成的,而新文章是手写的,两者混在
同一个目录里,所以有个隐患:重新跑一次迁移脚本,手写的文章会不会被一起删掉?
会。原来的实现就是 shutil.rmtree(content) 一把清空。所以我给它加了一个清单机制:
脚本把每一轮自己写出的文件记进 blog/.generated-manifest.json,下次只删清单里的东西。
手写文章和手动加的封面不在清单里,永远不会被碰。 清单丢了(比如新克隆的仓库)就干脆
什么都不删,只打印一句提示。只有 just reset 才会真正清空——那是个需要刻意敲的命令。
技巧
判断标准很简单:凡是脚本生成的,都在清单里;凡是你在编辑器里敲出来的,都不在。
AI 参与了多少
这个站点的迁移基本是我和一个 coding agent 一起做的,顺手记一下账,因为"AI 到底花了多少 token"这件事平时很少有人给出真实数字。
- Agent:DSH(DeepSeek Harness)的 Web 客户端,一个能读写文件、执行命令、开子代理的 编码 agent。
- 模型:
deepseek-v4-flash-vision-exp。
token 消耗分两段(下表是本文定稿时的快照):
| 阶段 | 模型调用次数 | 累计 token |
|---|---|---|
| 迁移(解析 dump、写迁移工具、生成 68 篇文章) | — | 55.1M |
| 本文所在会话(排查发布问题、做工具链、写这篇) | 134 | 15.24M |
15.24M 这个数字乍看很吓人,拆开看就不吓人了:
| 项目 | token | 占比 |
|---|---|---|
缓存命中的上下文(cacheRead) | 15,040,000 | 98.7% |
| 新读入的输入 | 52,417 | 0.3% |
| 模型输出 | 146,841 | 1.0% |
也就是说,每一步都要把之前的对话和读过的文件重新读一遍,平均每次调用的输入是 113k token 的上下文 + 394 token 的新内容。真正"生成"出来的只有 0.20M。 上下文长度才是成本的主项——这也是为什么让 agent 少读无关文件、把大任务拆成子代理, 比你换一个更便宜的模型更省。
这两个数字不是估的:harness 会把每次模型调用的 usage 明细写进会话日志,把 134 条记录
加起来就是上表的合计。
顺手记下来的几个技术坑
留两个纯粹给未来的自己看:
- Hugo 的
replace和replaceRE参数顺序不一样。replace是replace INPUT OLD NEW,所以不能用管道接(管道会把值追加到末尾,于是你拿到的是 一个静默错误的结果);replaceRE是replaceRE PATTERN REPLACEMENT INPUT,可以接。 我第一版骨架里管道接了replace,生成出来的标题是"-"。 shutil.copytree不会覆盖已存在的目录。 加了上面的"清单机制"之后,某些路径下目标 目录不会被预先删除,于是copytree直接抛FileExistsError。要加dirs_exist_ok=True。
最后
现在这个博客是:一份 Markdown、一个 Git 仓库、一次 git push,构建在 Cloudflare 的边缘
节点上,没有数据库、没有后台、没有插件需要升级。
发文章的成本从"登录后台 → 找编辑器 → 担心格式"变成了"打开编辑器 → 敲 just new → 写完
push"。对我来说这才是这次迁移最值的地方。
后面要做的还有两件:把 baseURL 换成正式域名后重跑一遍 sitemap,以及给旧文章补上封面图。